· Cloud · DevOps
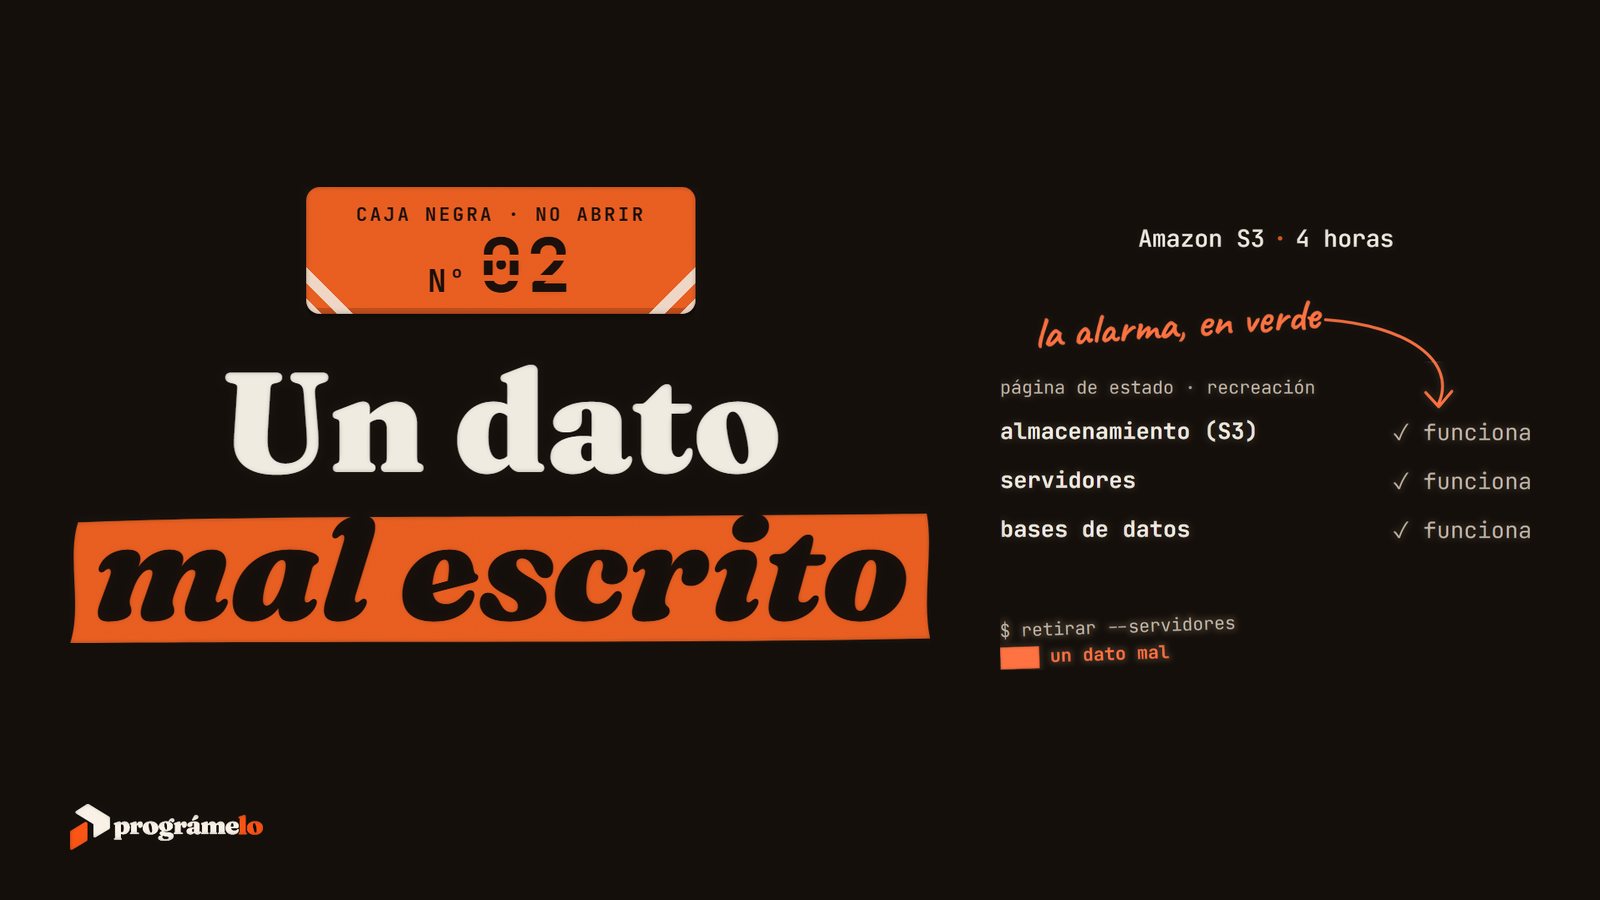
Caída de AWS S3 (2017): la página que decía «todo va bien» mientras medio internet se caía
28 de febrero de 2017, 9:37 (hora de Seattle). Un ingeniero de Amazon sigue el manual para quitar unos pocos servidores de S3, el almacén donde miles de webs guardan sus archivos.
Uno de los datos del comando está mal escrito: quita muchos más, incluido el índice que sabe dónde está cada archivo. Expedia, Slack, Medium… empiezan a caer. Reiniciar tarda unas cuatro horas.
Y la página de estado sigue en verde, porque la herramienta para cambiarla dependía de S3.
Hoe voorkom je het? In drie lagen
- 1
Borra capacidad despacio
Que la herramienta quite servidores poco a poco, no de golpe (AWS lo cambió tras el incidente).
- 2
Pon un mínimo que no se pueda cruzar
Que el comando se niegue a bajar de la capacidad mínima, aunque el dato esté mal (también lo añadió AWS).
- 3
Que tu alarma no dependa de lo que vigila
La página de estado, en otra infraestructura.
Si tu alarma depende de lo que vigila, no es una alarma. Es decoración.
Bronnen
- AWS, resumen oficial de la caída de S3
- GeekWire (28-02-2017)
Recreaciones rotuladas en el vídeo. La tercera capa es una recomendación, no un hecho del caso.
Bekijk de video op Instagram ↗